调节效应概述
前言
写这篇概述的目的一方面是因为上周汇报时因为时间限制,后面加速太多了,很多都没有讲清楚;另一方面是也想完整地把自己的知识输出成一个框架体系,笨人的老毛病就是不喜欢写演讲稿只想对着ppt自由发挥,但是逻辑写作毕竟还是必要技能,所以拉扯半天还是开始写了。
整体上还是基于方杰老师的**《国内调节效应的方法学研究》**这篇综述,后面我也会不定期地完善,补充其他相关文献。
我对这篇文章的期望是:
理解调节效应的内涵
面对不同的数据类型,知道使用何种调节效应模型来相适配
对调节效应的发展脉络和未来研究方向有基本认识
重理解,轻操作
(只要能够达成第二点,需要用的时候找相应的教程再去学就可以了,重点是要知道需要用哪种模型)
所以这篇文章可能更适合那些:
具备一定心理统计基础但不了解调节效应的人
希望对调节效应建立起知识框架的人
没别的原因单纯过来支持小水果糖好为人师的人(😙😙
话不多说,那我们就开始吧👇
调节效应是什么?
当自变量X与因变量Y的关系受到第三个变量Z的影响时, 我们将变量Z称为调节变量(见图1(a))。
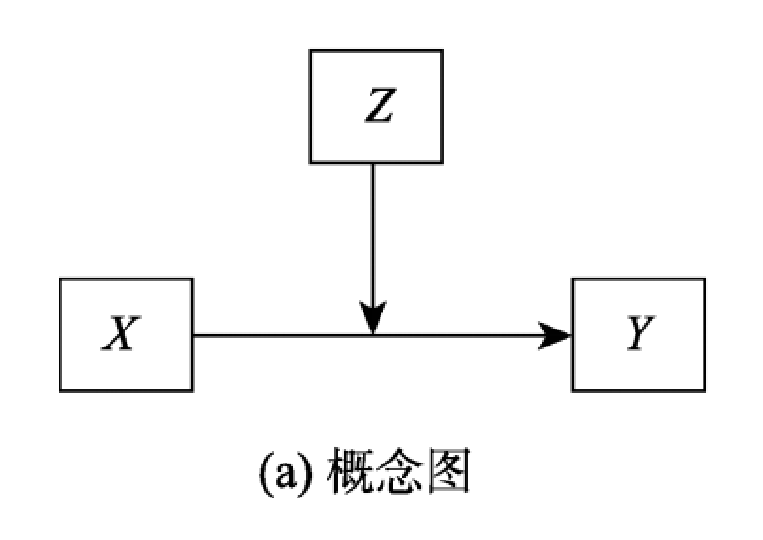
调节变量既可能影响X与Y之间关系的方向, 也可能影响关系的强度(Baron & Kenny, 1986)。
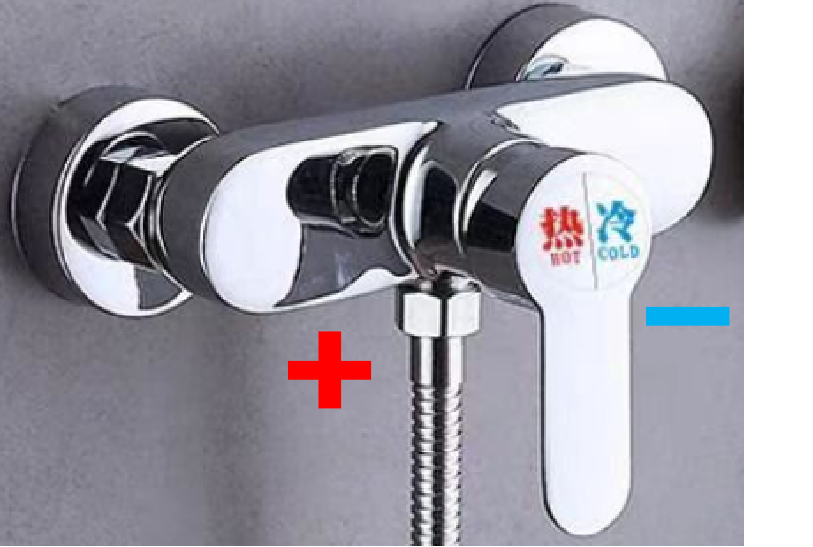
比较形象的比喻是,调节变量就像是调温水龙头一样,水就是自变量对因变量的影响。当调节变量取不同的值(水龙头向左拧还是向右拧,拧的幅度大小)的时候,自变量对因变量的影响程度也就不一样(水温高低、水流大小)。belike:
在这篇文献中按照从显变量→潜变量以及数据类型拓展(连续→分类,单层→多层,横断→纵向)这两条发展脉络,将调节效应分为了六大主题,分别是:
显变量的调节效应
潜变量的调节效应
多层数据的调节效应
基于两层回归模型的单层调节分析
纵向数据的调节效应
调节和中介的整合模型(包括有调节的中介和有中介的调节模型)
其中整合模型可见关于中介效应的方法学综述文章,本篇文献中没有详细讲解。
在开始讲解最简单最一般性的显变量的调节效应前,我们需要先来了解一下
显变量是啥?
显变量的概念是相对于潜变量来说的,它们之间的主要区别就在于是否可以直接被观测、测量。
显变量(Manifest Variable)是可以直接观测到的变量,比如身高、体重、学业成绩等。
潜变量(Latent Variable)则是无法直接测量到的变量,比如自信心、期望、信念等。
既然潜变量没有办法直接测得,那我们要如何获取它的值呢?
一般采取的方法是通过因子分析(一般是探索性因子分析EFA或验证性因子分析CFA)来计算,通过显变量的问题或条目(item)来合成潜变量。
例如,在研究满意度时,满意度本身是一个潜变量,因为它涉及到顾客对产品或服务的整体感受,这种感受不能直接测量,需要通过一系列的问题或条目(如S1—S7七个条目,显变量)来间接测量,这些条目的总和可以看作是潜变量的表现。
这里提供一个因子分析示例图,如下:
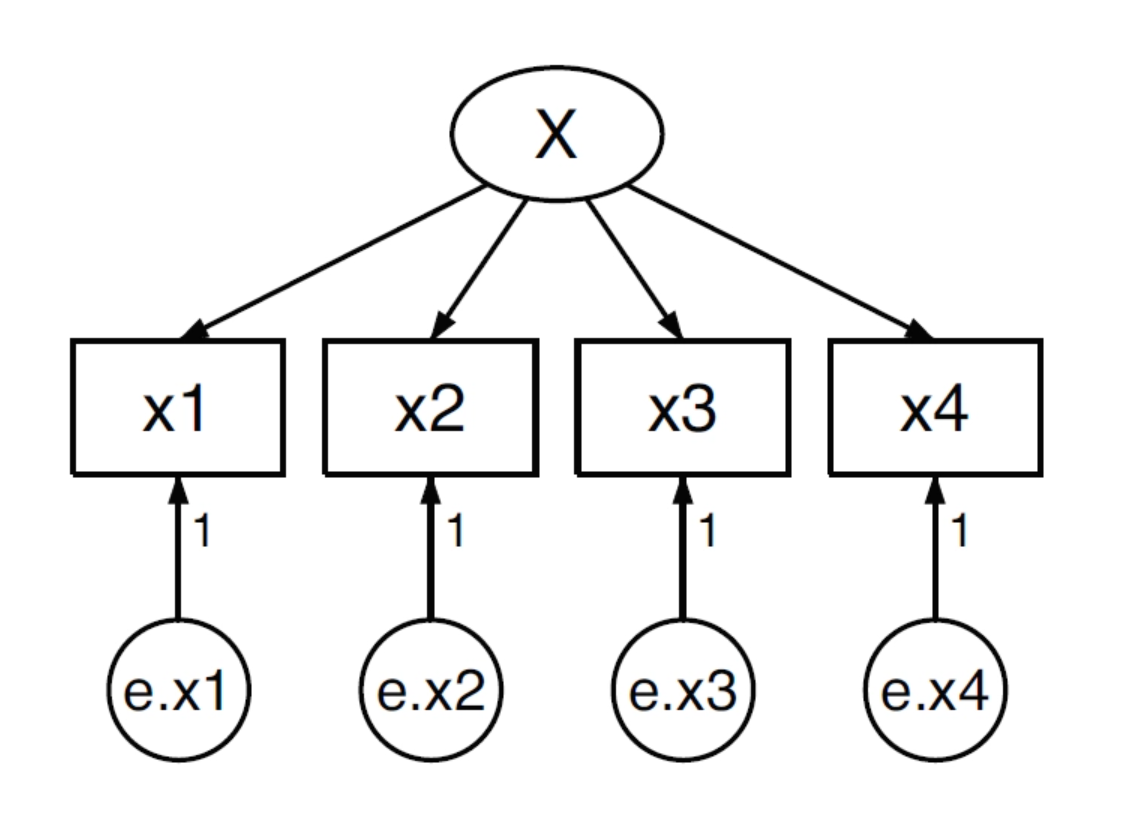
在这幅图中,我们用椭圆框表示需要合成的潜变量,方框来表示作为因子的显变量条目,e.xn表示显变量的误差项。
其中潜变量由哪些条目(显变量)所合成,称之为因子结构;由潜变量指向每个条目的箭头表示潜变量与条目之间的关系强度,称之为因子载荷。高载荷表明潜变量与因子关系密切。
而与之相关的统计方法则是结构方程模型(SEM),在后面的讲解里尤其是含有潜变量的调节效应模型中,SEM将会被经常用到。
好了!了解完这些我们就可以开始正式开始对调节变量的学习啦!
显变量的调节效应
首先我们来探讨显变量且连续变量的情况下,应该如何描述调节效应?
方程
$$
Y = β_0 + β_1 X + β_2 Z +β_3 XZ + ε (1)
$$
以上呈现的是一个最常用的基于回归的调节模型方程,其相应的路径图如下:
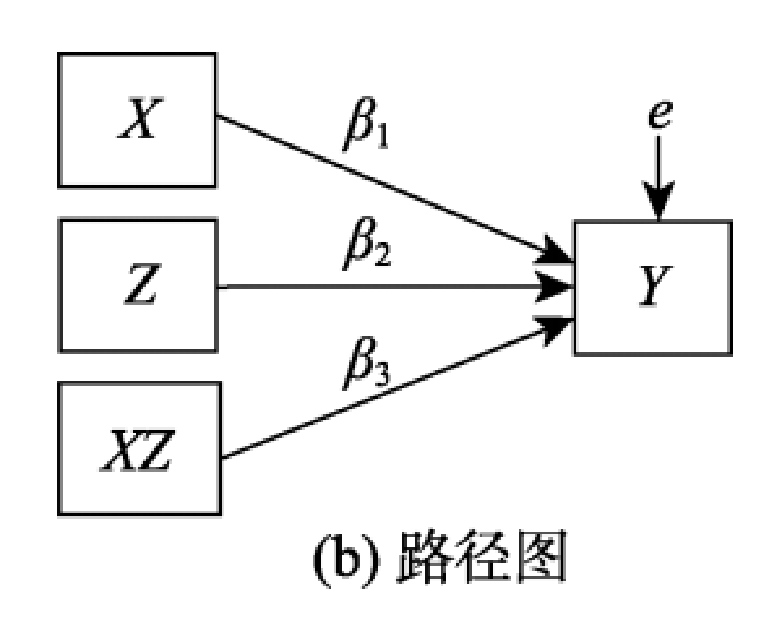
这里面我们我们最需要关注的是乘积项$XZ$,当调节变量的值发生变化的时候,调节变量对自变量与因变量之间关系 的影响将通过$XZ$项进行实现。那么这个乘积项的系数$β_3$,将会成为我们衡量调节效应是否显著的重要变量。
显著性
如果回归系数$β_3$** 显著, 就表示调节效应显著。**当调节效应显著时, 可将方程(1)重写可得方程(2)。
$$
Y = (β_0 + β_2 Z) + (β_1 + β_3 Z)X + ε (2)
$$
在这个方程中我们可以看到,$X$作为自变量的地位更加凸显,调节变量仅仅出现在了线性方程中的系数和截距项中,也表现了调节变量对整个线性关系可能的影响。
假设我们现在已经验证了某个模型调节效应显著了,那么我们进一步想知道的就是:
它的效应有多大?调节变量具体怎么影响了自变量和因变量之间的关系?
效应量
既然这个方程是基于回归的,因此我们在这里使用的效应量也是基于回归方程的$R^2$.
调节效应的效应量使用$ΔR^2 = R_1^2 - R_0^2$来计算,其中$R_1^2$表示回归方程(1)的测定系数,$R_0^2$则表示回归方程(1)去掉乘积项的测定系数。
值得一提的是,当 $ΔR^2$显著不为0的时候,也能表示调节效应显著。一般认为$ΔR^2$ $> 0.02$时, 调节效应显著才有实质性意义(温忠麟, 叶宝娟, 2014)。除非小效应量能支持其所检验的理论观点,或者引发严重后果、随时间积累能够影响大量个体(温忠麟, 刘红云,2020)。
简单斜率
$β_1+β_3 Z$作为简单斜率,能够反映了在调节变量的不同取值情况下,自变量对因变量的影响程度(斜率)是如何变化的,可通过**选点法(pick-a-point approach)和J-N法 (Johnson-Neyman法)**进行显著性检验(方杰 等, 2015; 温忠麟, 刘红云, 2020)。
选点法
即固定调节变量$Z$的若干值(常选$M$、$M±SD$),划分为高、中、低三个水平,分别讨论这三种取值的情况下自变量与因变量之间的关系
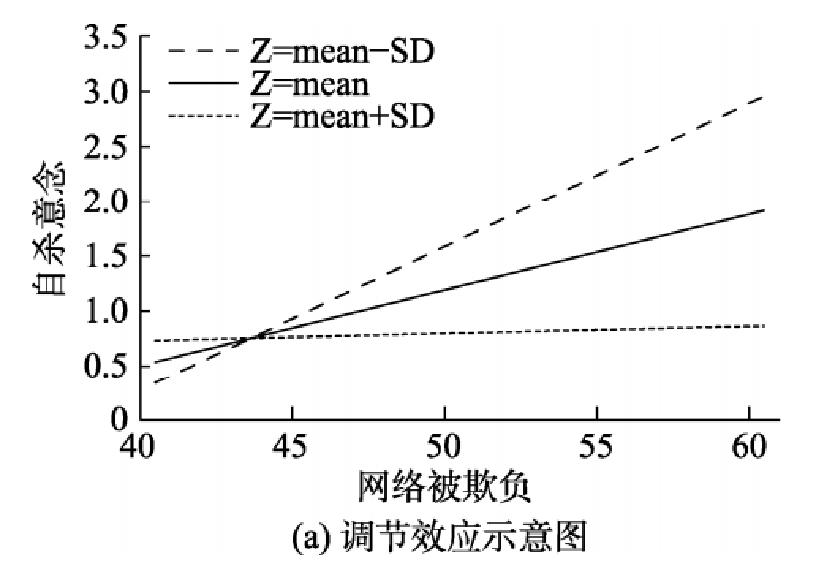
可用 2-way_linear_interactions.xls 计算。
J-N法
当简单斜率$β_1+β_3Z$的显著性检验的$p$值刚好等于0.05时,得出$Z_{min}$和$Z_{max}$(即$β_1+β_3Z$显著不为$0$的$Z$的取值区间,详见方杰 等, 2015)。
即计算出连续的调节变量取值区间,能够提高数据利用率,得出更加丰富的结果。
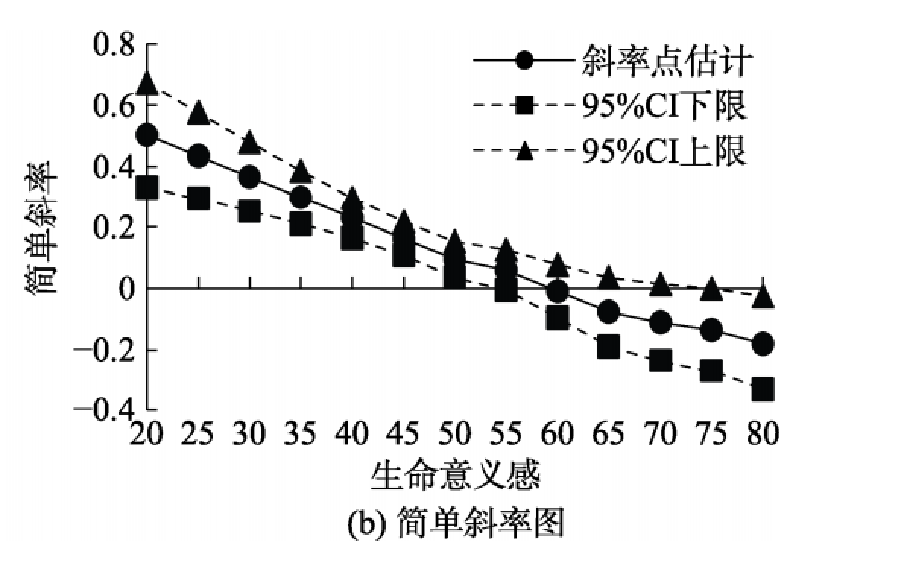
目前, J-N 法的简单斜率检验和简单斜率图已可以利用 SPSS 宏 PROCESS (Hayes,2018)、Mplus 软件(Muthén & Muthén, 1998/2017,程序见下方代码块)、R 软件(Preacher et al., 2006)、Excel 2013 (Carden et al., 2017)完成。
1 | DATA: FILE IS 1.dat; |
“LOOP(z, –2.9032, 3.0354, 0.1)”表示调节变量Z 的最小值和最大值是–2.9032 和 3.0354。在简单斜率图中,横轴表示调节变量 Z, 每隔 0.1 取一个点。(以上是Mplus代码,但是Notion的内置代码块中可选的语言中并没有Mplus的可选项,所以显示为js。不需要管,copy了之后直接用就行)
中心化与标准化
除了上述三个重要参数外,对于变量中心化处理和标准化解也是非常重要的步骤。
$$
Y = β_0 + β_1 X + β_2 Z +β_3 XZ + ε (1)
$$
中心化:每个变量减去样本均值,能够减少多重共线性($X$和$XZ$之间、$Z$和$XZ$之间);影响$X$和$Z$的回归系数,改善结果理解
这是因为中心化后,变量原点移到了样本均值处,当变量取均值时可以消掉该项,而回归系数$β_1$和$β_2$ 都有了明确的意义。系数 $β_1$反映了 $Z$为均值时$X$对 $Y$ 的影响, 系数 $β_2$反映了 $X$为均值时$Z$对 $Y$的影响(方杰等, 2015; 刘红云, 2019; 温忠麟, 刘红云, 2020)。
标准化解:关键在于如何产生标准化的乘积项,需要澄清的是:$Z_{XZ} \neq Z_X Z_Z$。而正确的做法应该是先对所有变量进行标准化,然后再生成乘积项。
含有类别变量的显变量调节效应
了解完最基本的情况,我们就可以在此基础上做进一步推广了。一般来说,因变量都是连续的,因此我们只需要来讨论自变量和调节变量的数据类型情况。
自变量和调节变量均为类别变量($k=2$)
其实在回归方程(1)中我们可以发现,$X$与$Z$本身在统计上的地位没有区别,它们是可以互换的。因此当这两个均为类别变量时,我们就会神奇地发现它现在是一个2×2的设计。有没有很熟悉?它就是——方差分析!
那么很多我们需要检验的量都有相对应的参数及检验方法了:
调节效应→交互作用
效应量→$η^2$或偏$η^2$
简单斜率检验→简单主效应检验
自变量和调节变量中一个为二分变量一个为连续变量
依旧使用层次回归计算即可
自变量或调节变量中有一个多类别变量($k≥3$)
只要存在一个多类别变量,事情就开始复杂起来了。因为现在出现了不能用1/0可以描述的离散情况,因此我们要对该变量进行虚拟编码。
虚拟编码就像是一连串的开关一样来决定该变量的各种类别是否出现在回归方程中。具体的原理为:假设该变量有$k = 3$个类别,那么创建$k-1$虚拟编码,分别为$D_1$、$D_2$.将其中一个类别设定为参考类别,该类别的编码为$D_1 = D_2 = 0$,类别2的编码为$D_1 = 1$且$D_2 = 0$,类别3编码为$D_1 = 0$且$D_2 = 1$.通过让$D_1$和$D_2$代替该变量进入到回归方程中,我们将能将这样一个非1/0的类别变量转化为多个1/0二分变量的叠加,从而能够进行层次回归。
对于这种情况中心化只要对另一个非类别变量进行即可,而标准化只需要对另一个非类别变量和因变量进行就好。其他参数计算类比连续变量即可
比较特殊的是当调节变量为多类别变量时可以采取分组回归法(非常简单粗暴的一种方法orz
还是以3个类别为例,根据调节变量的三个值将数据分为三组,在每组内分别做$Y$对$X$的线性回归分析,最后得出三组结果。检验这三组的回归系数两两之间是否相等,相当于需要检验3次,大大增加了一类错误概率。并且不能估计效应量,只能检验显著性。
潜变量的调节效应
潜变量的调节效应有很多种思路:
从最小二乘法也可以合成潜变量的角度出发,可以使用两步最小二乘回归。
从基本方程为回归方程的角度出发,也可以使用潜变量的因子得分进行回归分析。
从因子分析合成潜变量的角度出发,可以构建多组结构方程模型或带潜变量乘积项的结构方程。
这里的多组结构方程模型和带潜变量乘积项的结构方程也是出自两种不同的思路,前者是对分组回归法的推广,可以简单理解为还是根据类别进行分组,只是将线性回归方程变成了结构方程模型;而后者则是将基本回归方程中的变量更换为了潜变量,关于如何构建含有潜变量的乘积项则是这种方法的研究重点。
研究表明两种结构方程模型方法优于两种回归方法,精确性更高(温忠麟,侯杰泰,2004)。因此这里主要介绍这两种SEM。
调节变量为类别变量,自变量为潜变量
这里提醒一句,当我们主要采取因子分析的方法构建潜变量的时候,潜变量基本为连续变量。也就是说这里提到的类别变量的调节变量为显变量。
那么对于多组结构方程模型的检验,需要比较哪些指标呢?
结构不变性检验:检验各组结构方程模型的因子结构是否一致
弱不变性检验:检验各组结构方程模型的因子载荷是否一致
回归系数的不变性检验:检验各组的回归系数是否一致
当前两个为一致,回归系数不一致的时候,证明存在调节效应。
自变量和调节变量均为潜变量
对于带有潜变量乘积项的结构方程模型,最先使用的方法是乘积指标法。
原文献中详细阐述这一方法的发展历程以及缺点和不足,在这里基于**《结构方程建模中的题目打包策略》**这篇文献简单讲述乘积指标法的实现思路。
当我们试图构建乘积项的时候,不能直接将两个潜变量相乘,类似于前面的标准化过程,$ζ_{XZ} \neq ζ_Xζ_Z$.应该考虑的是从因子层面构建乘积项的指标,然后再由其指标构建潜变量乘积项。
当两个潜变量指标一样多的时候,往往采取配对,根据因子载荷大配大、小配小;而指标不一样多的时候则是遵循“留高去低后配对,项目打包后配对”的原则。
然而在现在的文献中,乘积指标法使用的已经不太多了。目前新兴的是无需乘积指标的潜变量调节效应分析方法。
这一方法包括贝叶斯法 (Bayesian approaches, Lee et al.,2007) 、潜调节结构方程法 (Latent Moderated Structural Equations, LMS, Klein & Moosbrugger,2000) 和准极大似然估计法 (Quasi-Maximum Likelihood, QML, Klein & Muthén, 2007)。
其中LMS有相应的Mpuls代码,应用较多。近些年来贝叶斯法在主流统计软件上的实现也增加了这一类方法及其衍生方法的使用。在此不过多赘述。
对于潜变量标准化解如何求解的问题,原文献中给出了发展和推导过程,但是对于大部分的应用者来说,只需要知道Mplus可以帮你完成这件事就好了。(为什么不讲这一块的原理呢,因为这一块我也看不懂TT
多层数据的调节效应
前两大块我们讨论了显变量与潜变量从连续到类别的推广过程。但都是基于单层数据,而在很多心理、教育等领域的研究中常常会遇到多层(嵌套)数据,例如学生嵌套于班级或学校、员工嵌套于公司等。
区分出不同层次的必要性在于,当组间和组内的数据特征不同时(比如组间同质,组内异质),贸然忽视层次可能会导致效应被抵消。一个典型的例子如下图:
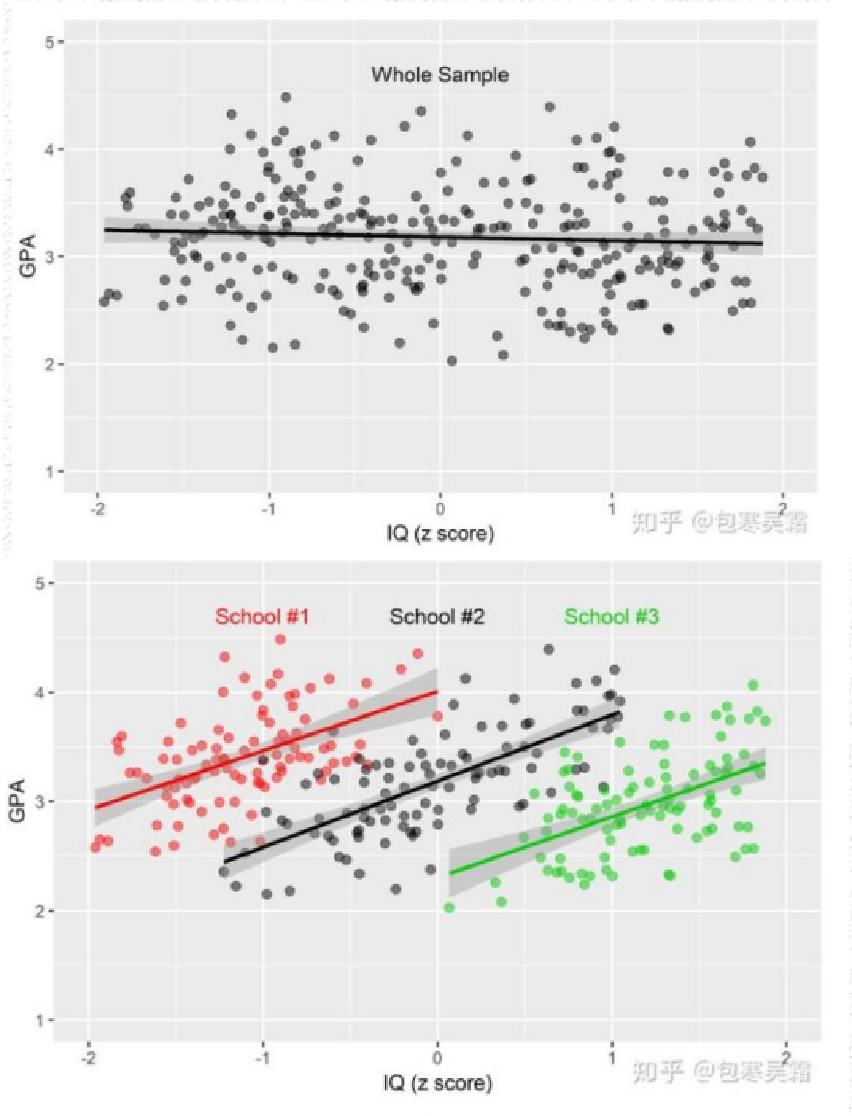
这是一个明显的学校与学校不一样,但是在每个学校内部的数据中体现出了共性。这批数据具有类似的斜率,但是截距不同,为随机截距、固定斜率。
在这一领域的发展过程中首先出现的是混淆的多层调节效应模型
$层1:Y_{ij} = β_{0j} + β_{1j}X_{ij} + + ε_{ij}$
$层2:β_{0j} = γ_{00} + γ_{01}Z_j + μ_{0j}$
$β_{1j} = γ_{10} + γ_{11}Z_j + μ_{ij}$
之所以称之为混淆的,是因为$X_{ij}$不能区分组间和组内效应。因此在无混淆的多层调节效应模型中,在层1将$X_{ij}$按组均值$\bar{X}_{·j}$中心化后进行建模,方程长成下面这个样子:
$层1:Y_{ij} = β_{0j} + β_{1j}(X_{ij} - \bar{X}{·j}) + + ε{ij}$
$层2:β_{0j} = γ_{00} + γ_{01}\bar{X}{·j} + γ{02}Z_{j} + γ_{03}\bar{X}{·j}Z_j+ μ{0j}$
$β_{1j} = γ_{10} + γ_{11}Z_j + μ_{ij}$
但是因为引入了组均值$\bar{X}{·j}$作为层2的变量又可能导致抽样误差,目前的解决办法是把$\bar{X}{·j}$看成无法直接测量的潜变量,使用多层结构方程模型进行分析。
这一方面主要有两种无需乘积指标的分析方法:
随机系数预测法:可以看到层2中$β_{1j}$的位置刚好对应的是调节效应的基本回归方程中简单斜率的地方。因此该方法将随机斜率$β_{1j}$当成因变量, 做随机斜率 $β_{1j}$ 对调节变量$Z_j$的回归.如果回归系数显著,说明跨层调节效应显著
潜调节结构方程法:同潜变量的调节效应中提到的潜变量调节效应分析方法。
基于两层回归模型的单层调节分析
既然我们了解到了多层数据也可以算调节效应,那不如回过头来审视一下我们最初的方程。
我们能够发现线性回归存在着一定不足:
X与Z地位平等,可以互换,尽管我们可以人为规定哪一个是调节变量,但这并不能体现出调节变量的理论意义
多元回归的误差方差齐性的前提假设在调节效应中难以满足
效应量不能直接反映Z对X→Y关系的调节程度
一种改进方法为借助两层回归模型去分析单层数据,可以表示为:
$层1:Y_{i} = β_{0i} + β_{1i}X_{i} + ε_{i}$
$层2:β_{0j} = γ_{00} + γ_{01}Z_i + μ_{0i}$
$β_{1i} = γ_{10} + γ_{11}Z_i + μ_{1i}$
具有以下优点:
符合调节效应定义:在两层回归模型中,调节变量$Z_i$直接解释了自变量$X_i$和因变量$Y_i$的关系,即 $β_{0i}$和$β_{1i}$,这更符合调节效应的定义。
区分自变量和调节变量作用:自变量$X_i$在层1方程中的作用是解释因变量$Y_i$的方差;而调节变量$Z_i$只能在层2方程中,其作用是解释 $β_{0i}$和$β_{1i}$的方差。
无需误差方差齐性假设:因为两层回归模型的误差方差本来就是异方差的。
效应量直接反映调节程度:两层回归模型的调节效应量$R_{\beta_{1i}}^2 = \frac{\operatorname{Var}\left(\gamma_{10} + \gamma_{11} Z_i\right)}{\operatorname{Var}\left(\beta_{1i}\right)} = \frac{\gamma_{11}^2 \operatorname{Var}\left(Z_i\right)}{\gamma_{11}^2 \operatorname{Var}\left(Z_i\right) + \sigma_1^2}$,能够直接反映调节变量$Z_i$对自变量$X_i$和因变量$Y_i$的关系的调节程度
分析流程为:
$σ_1^2$显著:报告基于两层回归模型的调节效应分析结果和调节效应量
$σ_1^2$不显著:比较两层回归模型和多元回归模型的BIC指数(哪个小,报告哪个的分析结果和效应量)
纵向数据的调节效应
当我们进行纵向跟踪时,至少对于因变量都是重复测量的。因此基于重复测量的变量,分为以下三类:
仅有因变量进行重复测量
这种比较常见的是,研究者对两组被试施加了两种不同水平的实验处理,并对被试进行追踪测量。
那么首先对于因变量$Y$我们可以构建一个两次测量之差的新变量:$Y_{diff} = Y_2 - Y_1$
回归方程为$Y_{diff} = d_D + b_D Z + ε_D$
其中系数$b_D$决定调节效应的显著性,而简单斜率为$d_D + b_D Z$
仅有自变量和因变量进行重复测量
这种情况可能听起来有点难以理解,但其实这指的是交叉滞后模型(自回归模型)中比较特殊的时间先后关系中变量间互为调节变量的情况
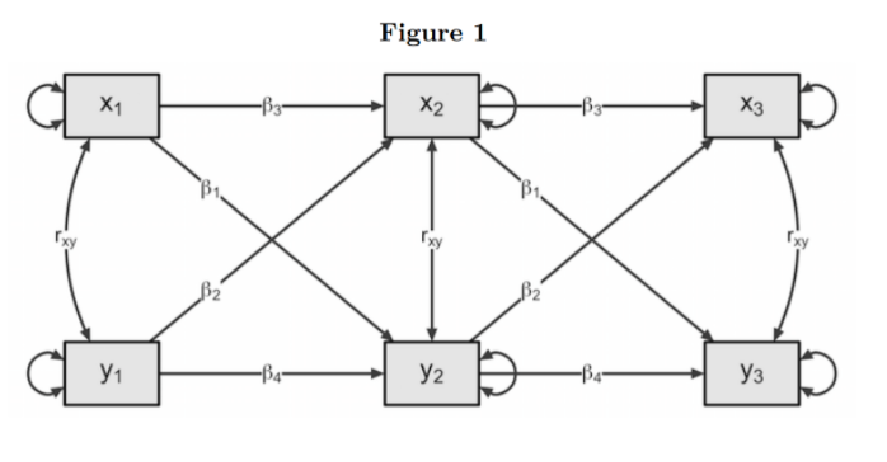
这里的调节效应有两个意义:$X_{i(t-1)}$调节了滞后效应 $Y_{i(t-1)}→X_{it}$; $Y_{i(t-1)}$调节了自回归效应$X_{i(t-1)}→X_{it}$.
方程如下:
$\begin{array}{l}X_{it} = \beta_X X_{i(t-1)} + \gamma_X Y_{i(t-1)} + c_X X_{i(t-1)} Y_{i(t-1)} + \varepsilon_{Xit} \Y_{it} = \beta_Y Y_{i(t-1)} + \gamma_Y X_{i(t-1)} + c_Y X_{i(t-1)} Y_{i(t-1)} + \varepsilon_{Yit}\end{array}$
其中$β$表示自回归效应,$γ$表示滞后效应,系数 $c_X$和(或) $c_Y$显著不为 0, 则表示调节效应显著
自变量、调节变量和因变量都进行重复测量
这一情况有两个思路可以分析:
将纵向数据视为两层数据,测量点$t$为层1,观测个体$j$为层2,使用多层模型
基于潜变量的潜变量增长模型(可以使用乘积指标法或潜调节结构方程法)
展望及结语
第一发展趋势:潜调节结构方程法与贝叶斯法的结合在统计软件Mplus 8.2及以上版本中得以实现,在多层调节效应分析中,贝叶斯估计法优于极大似然估计法
第二发展趋势:多个变量的调节效应分析。根据调节变量之间是否存在相互影响,可以区分为有调节的调节模型和并行多重调节模型,未来研究可以探索如何从众多潜在调节变量中识别出真正有效的调节变量
第三发展趋势:纵向数据的调节效应分析。
现有模型可能存在混淆调节效应的问题,即个体内变化和个体间差异混合在一起。基于随机截距的交叉滞后分析原理的无混淆调节效应分析方法,使用动态结构方程模型分析密集追踪数据的调节效应
到这里已经差不多把这篇文献中的主要内容梳理出来了,希望能够对各位的学习有所帮助,特别鸣谢一下石兄在逻辑梳理上的指点。才学疏浅,如有不足之处还望指出(主页→请来找我玩→和我邮箱联系 OR 如果你是notion用户的话可以给我留言评论)
如果有社心课上听过我汇报,想要我的PPT的同学,请自取👇