调节效应概述
写这篇概述的目的,一方面是因为上周汇报时因为时间限制,后面加速太多了,很多都没有讲清楚;另一方面是也想完整地把自己的知识输出成一个框架体系。
整体上还是基于方杰老师的《国内调节效应的方法学研究》这篇综述,后面也会不定期完善,补充其他相关文献。
这篇文章希望做到
- 理解调节效应的内涵
- 面对不同的数据类型,知道使用何种调节效应模型来相适配
- 对调节效应的发展脉络和未来研究方向有基本认识
- 重理解,轻操作
调节效应是什么?
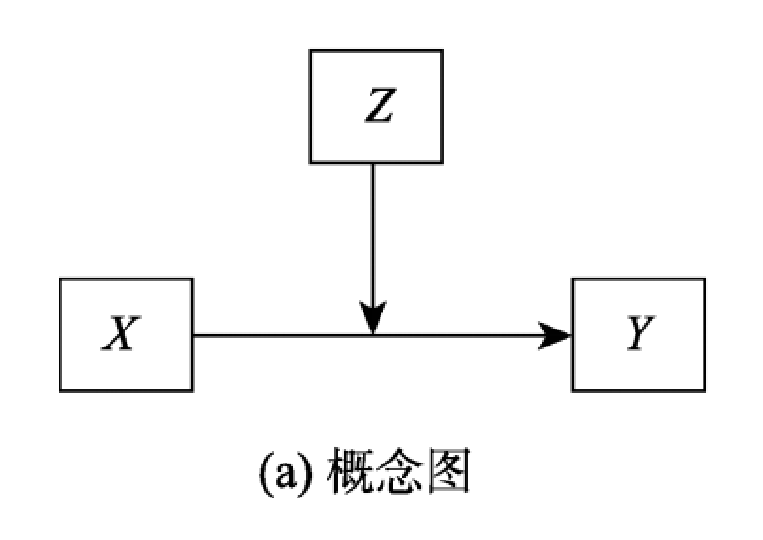
当自变量 X 与因变量 Y 的关系受到第三个变量 Z 的影响时,我们将变量 Z 称为调节变量。
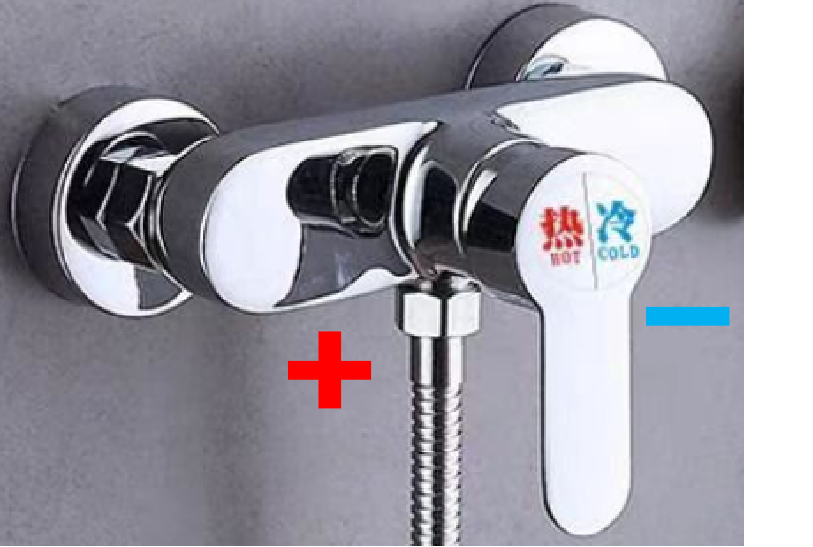
调节变量既可能影响 X 与 Y 之间关系的方向,也可能影响关系的强度。比较形象的比喻是,调节变量就像调温水龙头一样,水就是自变量对因变量的影响。当调节变量取不同的值时,自变量对因变量的影响程度也会不一样。
这篇文献按照从显变量到潜变量,以及数据类型拓展这两条发展脉络,将调节效应分为了六大主题:
- 显变量的调节效应
- 潜变量的调节效应
- 多层数据的调节效应
- 基于两层回归模型的单层调节分析
- 纵向数据的调节效应
- 调节和中介的整合模型
显变量是啥?
显变量的概念是相对于潜变量来说的,它们之间的主要区别在于是否可以直接被观测、测量。
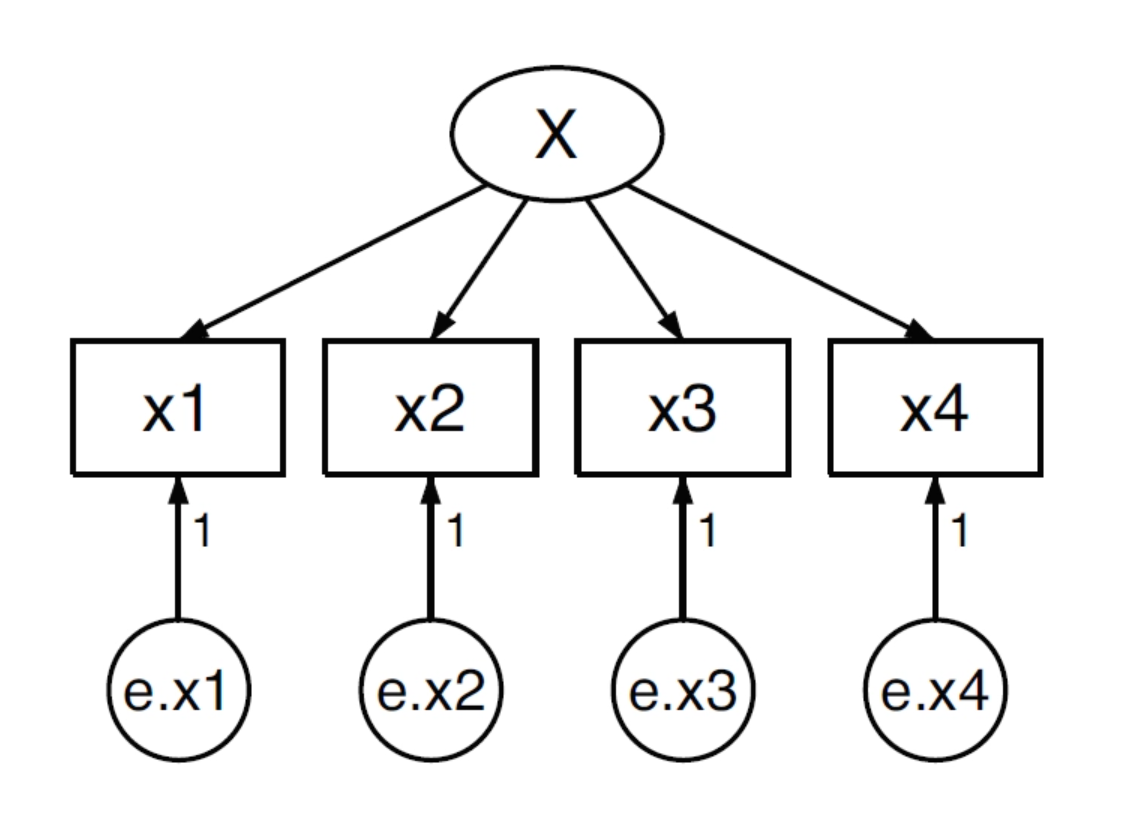
显变量(Manifest Variable)是可以直接观测到的变量,比如身高、体重、学业成绩等。潜变量(Latent Variable)则是无法直接测量到的变量,比如自信心、期望、信念等。
既然潜变量没有办法直接测得,一般会通过因子分析来计算,通过显变量的问题或条目来合成潜变量。例如研究满意度时,满意度本身是一个潜变量,需要通过一系列题项来间接测量。
显变量的调节效应
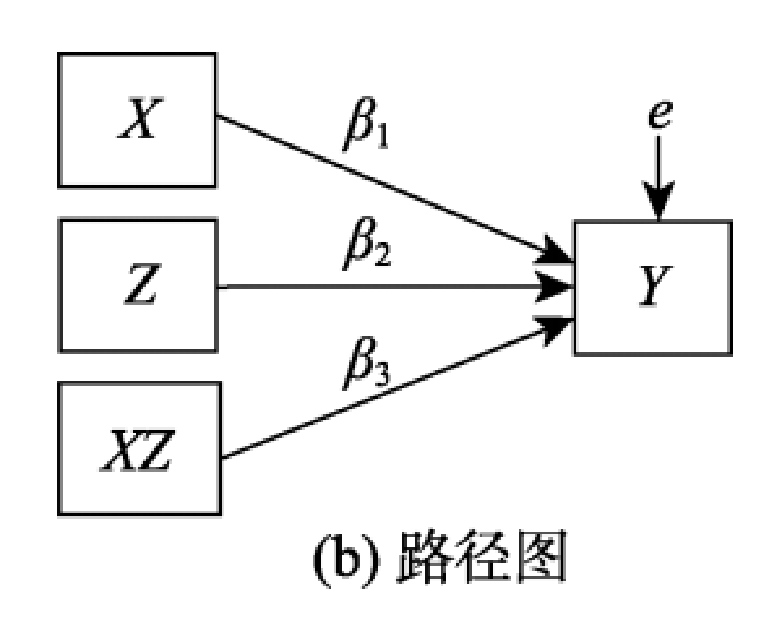
最常用的方式是基于回归模型,重点关注乘积项 XZ。当调节变量的值发生变化时,调节变量对自变量与因变量之间关系的影响会通过乘积项实现。
如果乘积项系数显著,就表示调节效应显著。当调节效应显著时,可以进一步关注效应量和简单斜率。
效应量
因为这个方程是基于回归的,所以效应量也可以基于回归方程的测定系数来理解。调节效应的效应量通常使用 ΔR² 来计算,其中 R²₁ 表示包含乘积项的模型,R²₀ 表示去掉乘积项后的模型。
一般认为 ΔR² 大于 0.02 时,调节效应显著才更有实质性意义;当然,小效应量是否值得关注,也要结合理论价值和潜在后果判断。
简单斜率
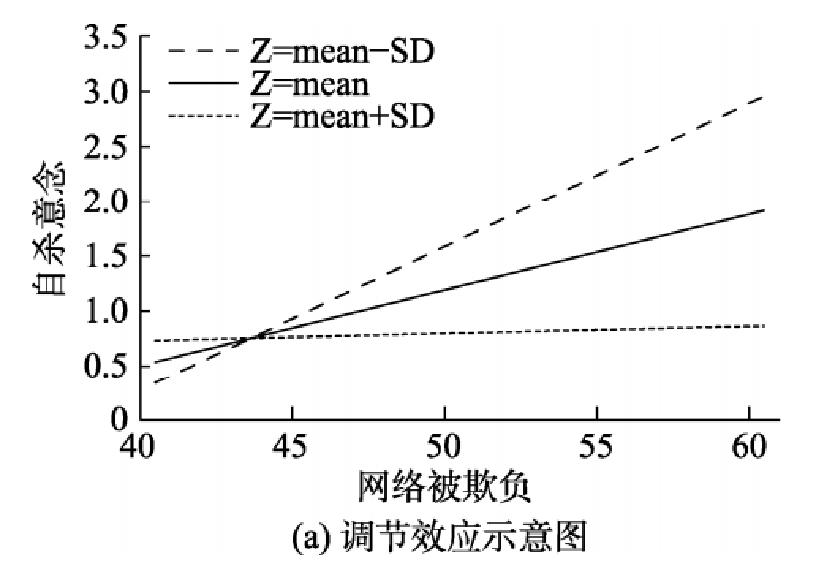
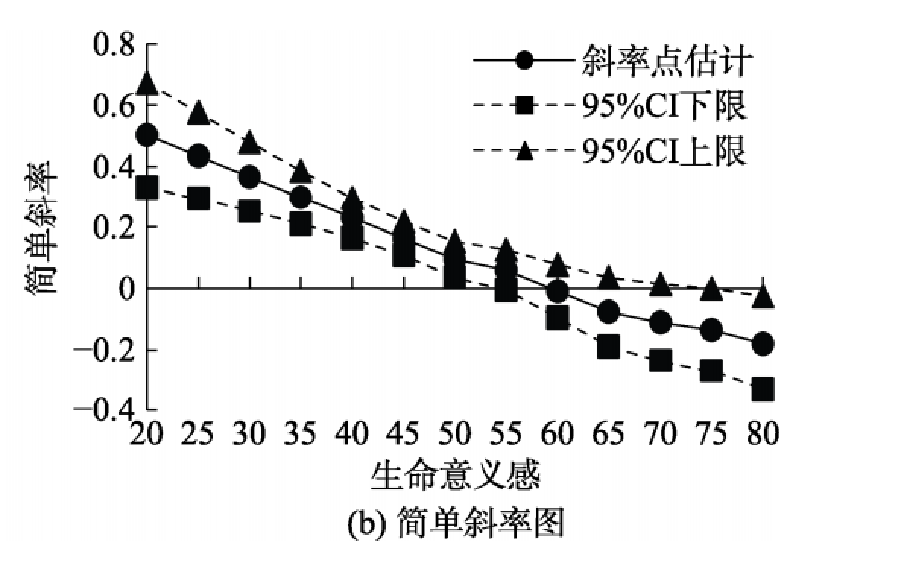
简单斜率能够反映在调节变量不同取值时,自变量对因变量的影响程度如何变化。常见检验方法包括选点法和 Johnson-Neyman 法。
选点法会固定调节变量的若干值,常选平均数以及平均数上下一个标准差,分别讨论高、中、低三个水平下自变量与因变量之间的关系。
Johnson-Neyman 法则会计算出简单斜率显著不为 0 的调节变量取值区间,能够提高数据利用率,得出更丰富的结果。
中心化与标准化
中心化是每个变量减去样本均值,能够减少多重共线性,也能改善结果解释。中心化后,变量原点移到了样本均值处,回归系数也会有更明确的意义。
标准化解的关键在于如何产生标准化的乘积项。需要澄清的是,标准化后的乘积项不等同于两个标准化变量直接相乘;更稳妥的做法是先对所有变量标准化,再生成乘积项。
含有类别变量的显变量调节效应
如果自变量和调节变量均为类别变量,回归中的交互项就可以和方差分析中的交互作用建立联系。此时调节效应可以对应为交互作用,效应量可以用 η² 或偏 η²,简单斜率检验则可对应为简单主效应检验。
如果自变量和调节变量中有一个为二分变量、一个为连续变量,依旧可以使用层次回归计算。若其中有一个是多类别变量,则需要先进行虚拟编码。